一格有多少星,先看格子多宽
先画一张出生质量直方图。横轴是质量,纵轴数每格有多少个分量。一格从一倍太阳质量延伸到两倍,另一格从两倍延伸到四倍;后者宽一倍。即使两格星数一样,也不能说它们的单位质量数目一样。
把出生质量写成太阳质量的倍数,用表示一个很窄区间内的期望分量数。这就是出生质量函数,也常简称IMF。它说的是许多可能群体的数目规律;一次抽出的1024个分量不会恰好等于每格期望。
如果横轴改成对数质量,同样宽的一格就对应不同的实际质量宽度。因此要先问论文画的是每单位质量的数目,还是每单位对数质量的数目。两个图的斜率不一样,未必是两套恒星物理。
对应阅读:Kroupa (2001), On the variation of the initial mass function
一条有限的分段幂律
本地多年龄模型采用一个明确截断的教学质量族:0.1至8倍太阳质量,在0.5处换斜率。这个选择让低质量成员和少量较重成员同时出现。它不是从M67数据恢复出的IMF,也不把0.1以下或8以上的星当作不存在。
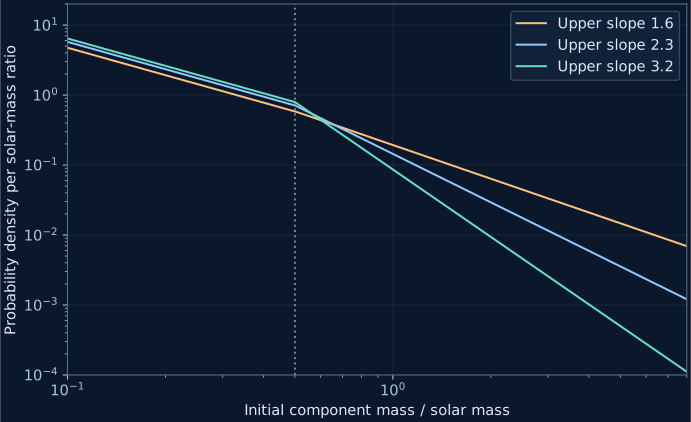
对一般斜率,质量从到的面积可以直接积分。指数恰好为一时,通常的分母会变成零,实际极限却很平稳:面积变成对数。
举个独立小例子:只看0.5至2倍太阳质量,斜率取2.3。1至2这一半区间的概率约0.288826。抽1024个分量,期望约296个落在这里;独立抽样时,标准差约14.5个。看到282个或307个,并不意味着抽样器违背了同一条IMF。这个例子用于算概率,质量支持与公开默认不同。
对应阅读:Kroupa (2001), On the variation of the initial mass function
从一枚均匀随机数得到一个质量
想象一条从零到一的纸带。把低质量段占的总概率涂在左边,高质量段涂在右边;一枚均匀随机数先决定落在哪段。进入某段后,再把这一段的累计面积倒过来,找到质量。这样就不用“随便挑个质量再反复拒绝”。
有限样本应保留种子和真正抽出的质量列表。种子帮助重放,不会把一次样本变成总体平均。检验抽样时也要分开两件事:确定性的累计分布计算是否正确,以及一次随机样本离它有多远。后者可以偶然越过事先规定的统计界。教程会保留一个这样的失败样本。
对应阅读:Kroupa (2001), On the variation of the initial mass function
只有98个原生节点时怎样抽
公开默认的许可模型只提供一段固定年龄的98个节点。最初我们试过抽连续质量,再对光度作分段线性插值。把隔行节点留出后,最大星等差约0.003018,超过预先写下的0.002探索门。这项失败没有变成“已通过”;公开默认也不继续使用那条连续光度分支。
现在让相邻节点的质量中点成为单元边界,最外边界就是原表支持端点。第个节点的权重,等于它那一格里的IMF面积占全部面积的比例。抽中一格就使用该格原生节点的质量和各波段光,完全不需要猜一个中间质量的光度。
这是一个质量离散化的条件群体。它保留每个质量单元的数目概率,却不保证离散节点的平均质量恰好等于连续IMF的平均质量。保存记录中的出生总质量必须由实际抽出的节点相加,不能拿连续期望偷换。节点间隔不均匀,给每行相同概率更会引入没有物理根据的数目偏置。
对应阅读:Reyes et al. (2024), a precise M67 isochrone; native ISOA data
先抽分量,再给它们找同伴
如果先抽一颗主星,再随手给它加一颗伴星,新增分量就会改变原先说好的分量质量分布。这里先抽完1024个分量,再随机打乱身份,把其中一部分两两配对。每个身份只用一次,未配对的仍是单星系统。
目标比例0.35、分量数1024时,实际配出265对,剩下759个系统,双星系统比例约0.349144。舍入差留在读数里。所有分量的质量相加与所有系统出生质量相加应相等;这项质量守恒约束针对同一批已抽出的分量;改变质量分布斜率后,抽出的总质量可以改变。
我们采用随机配对,不声称复现真实双星质量比规律。下一章不再抽新星,而是接过这一份身份和质量列表,把每个系统真正贡献的光算出来。
对应阅读:Kroupa (2001), On the variation of the initial mass function