先认出三个原件的身份
目标P Cygni的编号为HD193237。SWP36331在1989年5月23日观测,曝光2999.781秒;LWP15586在翌日观测,曝光239.493秒。它们覆盖不同紫外波段,日期接近,却不是完全同时的同一份观测。
另一个长波文件LWP04483来自1984年10月2日,曝光299.704秒,用于检查不同时期的轮廓。先验证完整文件的字节数与SHA,再读主头里的目标、观测日期、曝光和处理日期。九十年代的处理日期,不是恒星在那时又被观察了一次。
科学包包含原始公共任务的小型完整MXHI成员和独立Python,不需要下载光谱整库。它也保留NASA、ESA、英国IUE任务及STScI/MAST致谢。
python3 replay.py --inputs input --out-dir rerun对应阅读:IUE NEWSIPS manual, high-dispersion MXHI format · MAST original mission data use
一行里装着整条光谱级次
MXHI的主头后面是二进制表,不是一列简单的波长与流量。每行对应一个高色散级次,有17个字段;流量、噪声、质量等向量都补齐到768点。SWP36331含60个原生级次。
先读ORDER、WAVELENGTH、STARTPIX、DELTAW和NPOINTS。STARTPIX从一开始计数,它指出起始波长对应哪个原生像素。波长从那个位置往前或往后推,不能误把向量第零点当成起始波长。
ABS_CAL是绝对校准后的能量流量,单位为每平方厘米、每秒、每埃的尔格。NOISE的单位却是FN,处在另一校准层级;QUALITY是带符号整数存储的位标记。把FN噪声直接贴到ABS_CAL上当标准差,会造出错误的权重。
把质量缺口原样留下
默认选择只保留提取范围内、质量标记为零、ABS_CAL有限且非零的点。绘图时把被排除位置留成缺口,不跨过去连一条看似平滑的线,也不把负的有效流量全部截成零。
以两个硅候选窗口为例,原生99级和98级在各自八埃宽的区域里,分别有224、221个点,严格筛选后留下207、206个。这个选择是可重复的处理规则,不是给每个留下的点做了真实性认证。
IUE文档特别说明,高色散NEWSIPS没有自动清除宇宙线。异常点甚至可能带零质量标记。这里没有取得二维原像来完成逐点清理,因此尖峰、背景拟合和相邻级次的差异仍应作为检查线索。
对应阅读:IUE data-analysis FAQ · IUE NEWSIPS manual, high-dispersion MXHI format
统一到真空、日心与实验室参照
NEWSIPS波长已经采用真空标度,并做了日心速度修正。NIST的镁能级波数倒数给出两条实验室真空参照:约2796.3543与2803.5315埃。把空气波长混进来,或者再重复做一次日心修正,都会挪动线位。
把波长转成相对实验室波长的速度坐标时,红移取正。这个坐标仍包含恒星自身的系统速度。头里的LRADVELO描述处理所用速度校正,不是可以直接代入的恒星系统速度。
图上相对实验室的零点,与风相对恒星的零点应分别理解。蓝边还可能受离子范围、湍流、星际吸收和线重叠影响,不能从最左一个低点直接读出渐近终端速度。
对应阅读:IUE NEWSIPS manual, high-dispersion MXHI format · NIST magnesium energy levels
连续谱选择本身也要检查
镁窗口采用一条可复算的局部基线:取83级在2789至2791埃的质量零流量中位数,以及82级在2808至2810埃的中位数,再用直线连起来。1989年两个锚窗分别留下30与29点;1984年分别为29与29点。
这不是宣称那里有一条完美、无吸收的恒星连续谱。线遮蔽、级次拼接和校准都可能影响它。第一次只用一个级次寻找红端锚窗时没有有效点,原始失败和图已保存,最终步骤明确使用两个指定级次。
再改用2799埃处的常数基线,比较归一化轮廓怎样改变。在本例某些红分量窗口,差别可到约0.13个连续谱单位。这个差别量化处理敏感性,应与独立观测和统计标准差分别报告。
对应阅读:IUE data-analysis FAQ · Standalone stellar-wind scientific reproduction
先分别画级次和时期
运行probe-observation.py,查看两张镁图。每个时期把83、82级分别画出,质量缺口原样保留;不同颜色表示不同原生级次,不把重叠区悄悄平均。
两级提取来自同次观测,可能共享校准问题。它们的差别让人检查轮廓是否稳健,不能直接按两份独立重复实验来提高精度。1984与1989年也各占一幅图,恒星变化不会被平均掉。
硅窗口另画。短波中包含较复杂的线与吸收结构,本练习保留候选识别和基线选择,没有把它们塞进一条孤立线的定量拟合。
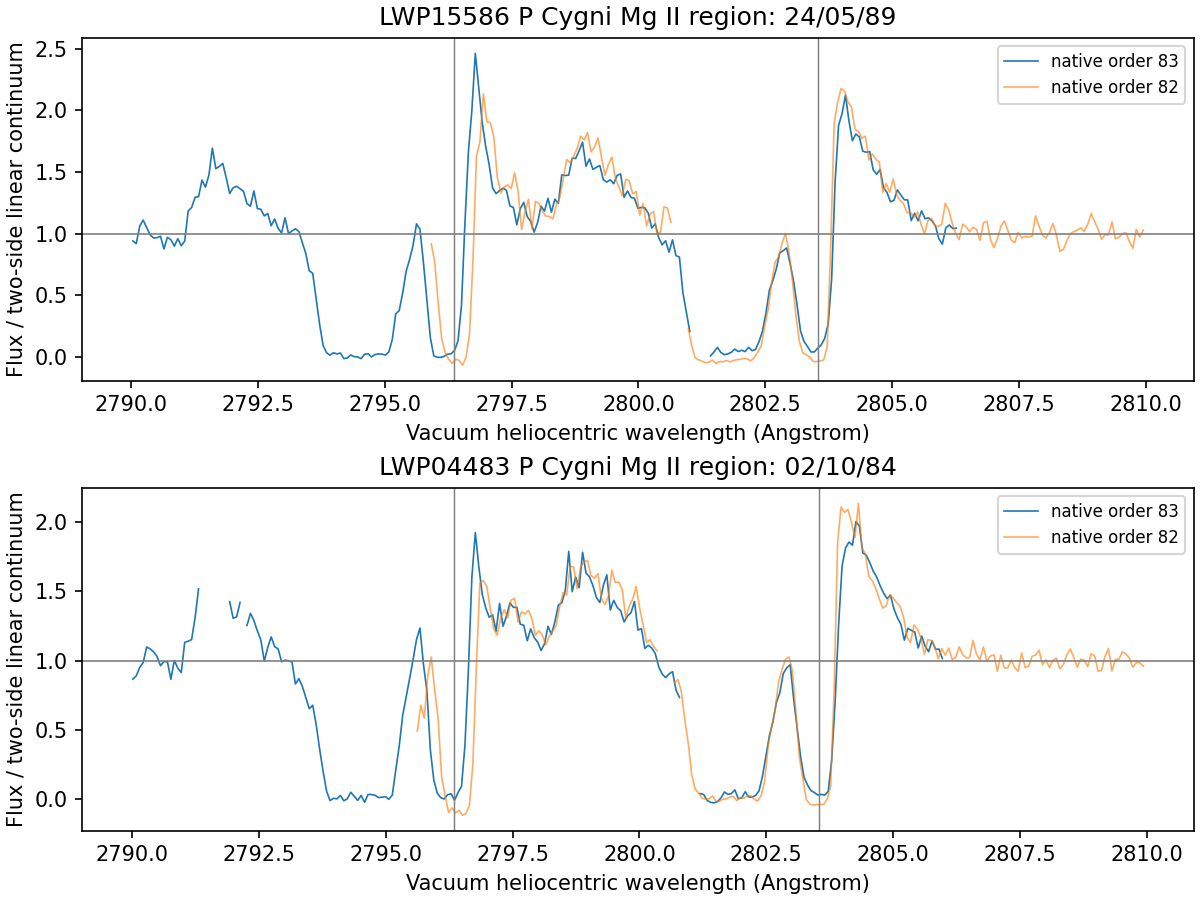
python3 probe-observation.py --inputs input --out-dir rerun对应阅读:IUE NEWSIPS manual, high-dispersion MXHI format · Standalone stellar-wind scientific reproduction
做一份条件明确的单线比较
compare_real_line_shapes.py重新计算一条孤立线参考,采用渐近速度每秒二百千米、速度律指数一、乘积参数一、完整孔径和示例仪器标准差每秒八千米。这条参考采用示例线展宽,未作IUE宽度标定或参数优化。
每个镁分量只取实验室参照两侧各每秒二百五十千米的窗口,分别比较,绝不把两条孤立线直接相加当成双重线传输。这个参考风的最大体速度为每秒176.25千米,在给定窗口和宽度下,两条参考分量保持隔离;真实混叠仍可能存在。
逐波长转换时,能量流量变成每速度单位的光子流量,需要乘波长与坐标Jacobian。但若数据和局部连续谱一起转换,这些因子在归一化比值中相消。归一化轮廓便可比较,同时保留真实连续谱结构与模型平坦照明之间的差别。
程序保存八组时期、级次、分量组合的残差。1989年蓝分量在83级的归一化均方根残差约为0.66,这组理想参考显然没有描述好实际轮廓。残差的形状可用于寻找恒星背景、星际吸收、离子布居、系统速度与仪器条件的问题,不能把这个数改叫卡方或质量损失误差。
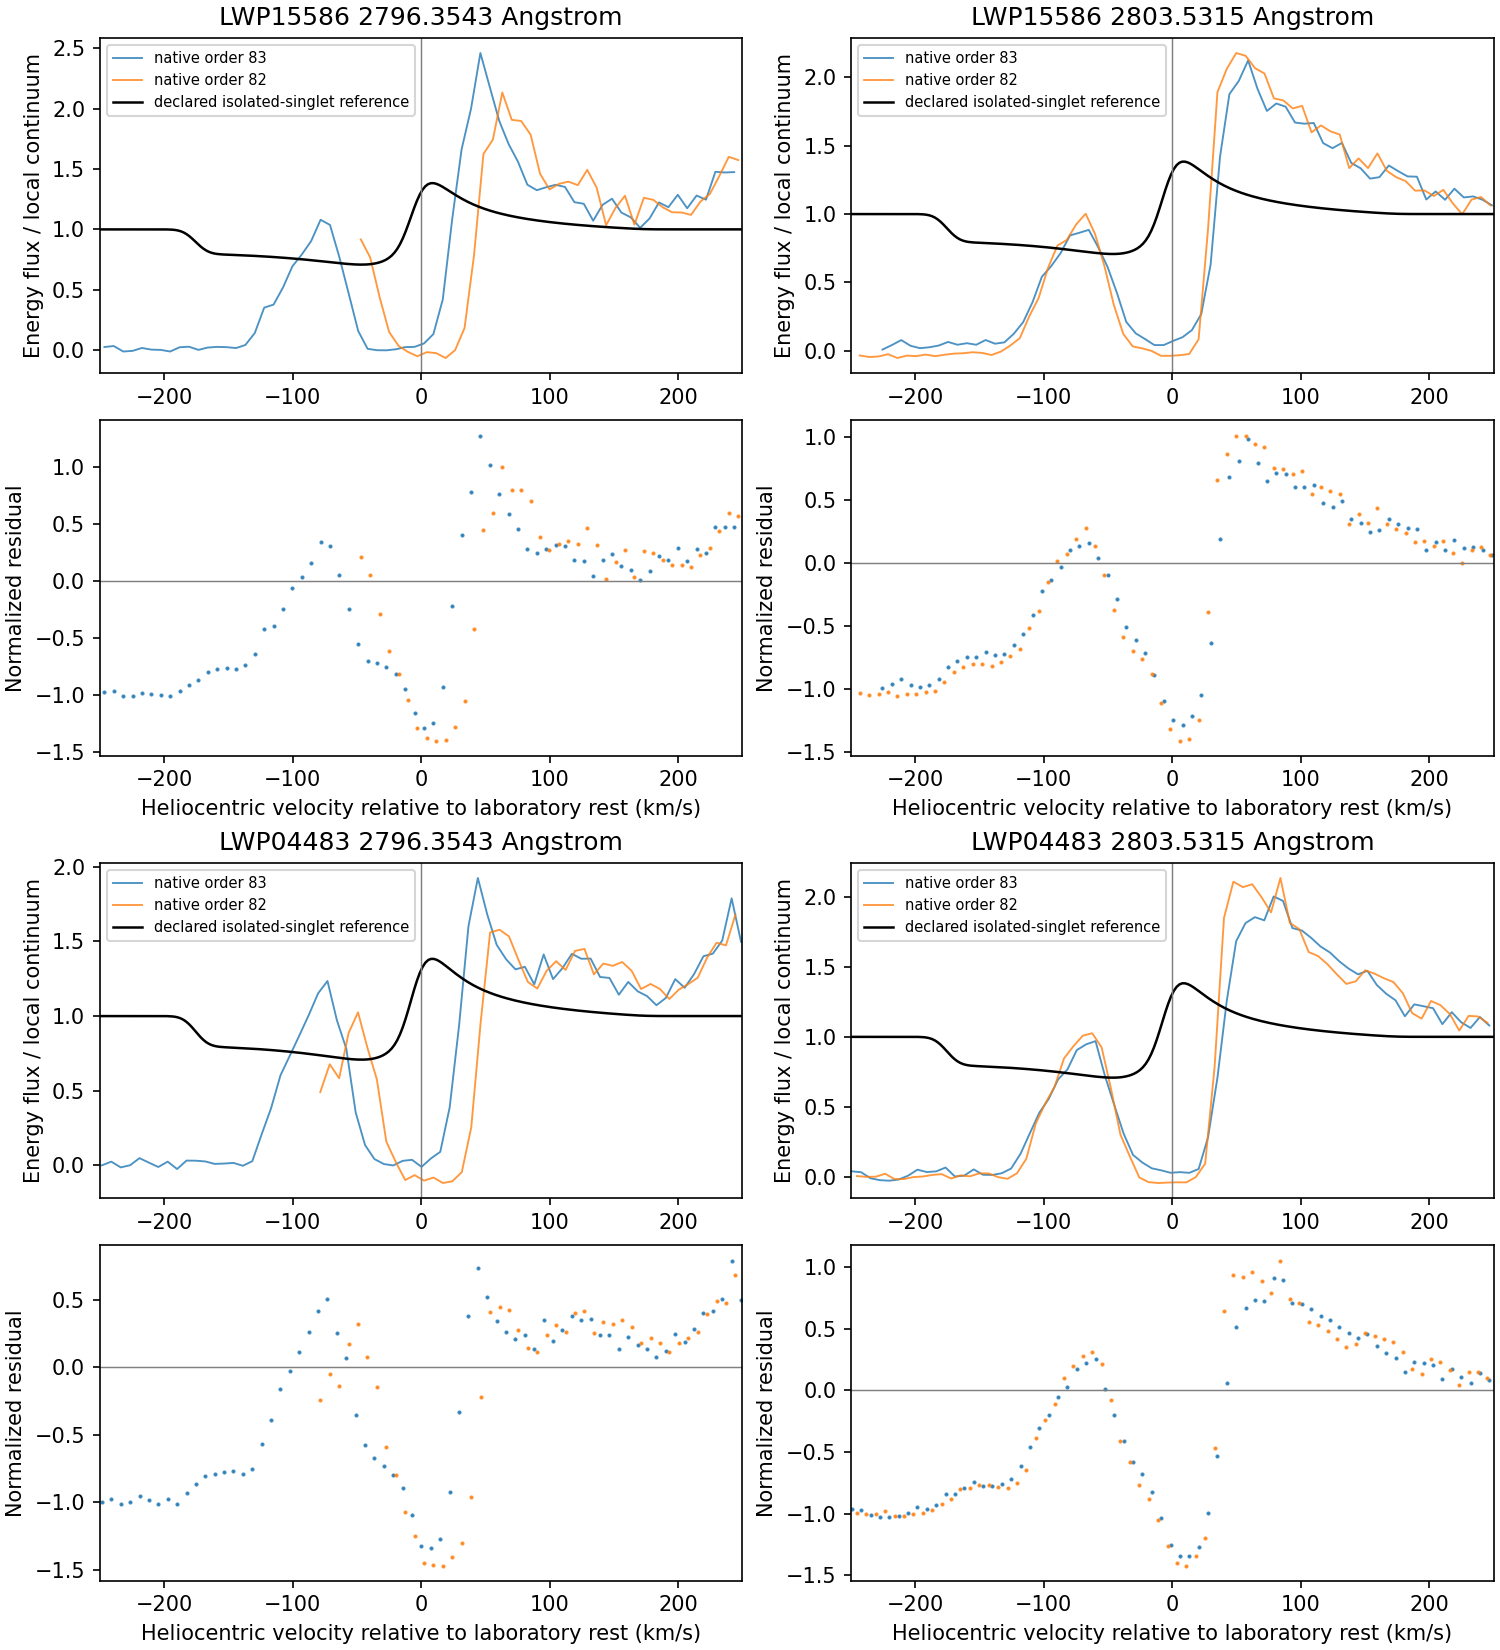
python3 compare_real_line_shapes.py --inputs input --out-dir rerun对应阅读:Standalone stellar-wind scientific reproduction · Lamers, Cerruti-Sola & Perinotto1987, the SEI line-profile method
为什么计数练习的区间不能搬过来
上一章的泊松练习有保存整数光子、已知连续谱与仪器、固定几何,以及质量流量和电离乘数各0.5至2的二维先验。即使条件如此清楚,一条线仍只辨识乘积。
三组各100次的固定真值检验里,质量流量区间分别覆盖100、100、0次。最后一组靠近先验边界,宽的先验退化带仍让中心区间反复排除固定真值。先验平均覆盖与这个逐点失败要一起解释,不能把宽区间包装成精密质量损失率。
IUE资料连这份合成计数练习的误差模型都没有直接给出。保持它的原始能量流量与FN噪声身份,比较可复算的轮廓、级次和连续谱敏感性,才是这批文件实际支持的练习。
对应阅读:Standalone stellar-wind scientific reproduction · IUE NEWSIPS manual, high-dispersion MXHI format
留下别人能重走的步骤
从空目录解包,安装requirements中固定的NumPy、SciPy、Matplotlib,再运行replay.py。它先检查输入字节与SHA,再真正重算传输、光子去向、力诊断、计数推断、IUE轮廓和公开表对照,全部成功后才生成收据。
阅读新的光谱时,可以重复这几个问题:坐标处在哪个参考系,哪些点被质量筛选,噪声与流量是否同单位,连续谱怎样选,比较模型究竟固定了什么。每个答案都应能在保存字段和计算命令里找到。
对应阅读:Standalone stellar-wind scientific reproduction · MAST original mission data use