跳到主要内容
Sandbox Physics
星系化学演化

星系化学演化 · L3

从气体轨迹走到一群恒星的丰度

气体轨迹给出每个时刻的成分,恒星分布还要问每个时刻形成了多少恒星。曲线上停留得久、形成得多的地方,会留下更多出生质量;望远镜选出的恒星又会改变我们实际看到的比例。

沿同一条线,不同地方留下多少恒星

设星形成速率为ψ(t)\psi(t)。在一个小出生区间里,锁入长寿命恒星与残骸的质量是(1−R)ψ(t)dt(1-\mathcal R)\psi(t)dt。把各区间累加,再除以总锁入质量,就得到归一化权重。

一条几何上走得很长的曲线,不一定在那里留下很多恒星。如果那个阶段星形成已经很弱,它对出生质量分布的贡献也很小。反过来,在较窄的丰度范围里持续形成恒星,会堆出明显的分布峰。

若某元素丰度Z(t)Z(t)严格单调,可以用变化率,把单位时间的出生质量换成单位丰度的出生质量。dMbirth/dZ∝ψ/∣Z˙∣dM_{\rm birth}/dZ\propto\psi/|\dot Z|只是这种单调情况下的写法;若稀释让轨迹回弯,同一个丰度可能对应几个出生时刻,必须把这些时刻的贡献相加。直接按时间积分更方便。

w(t)=(1−R)ψ(t)∫0T(1−R)ψ(b) dbw(t)=\frac{(1-\mathcal R)\psi(t)}{\int_0^T(1-\mathcal R)\psi(b)\,db}
w(t)dtw(t)dt是该时间段占出生锁入质量的比例。常数归还比例在分子、分母中消去,但不能把质量权重自动叫作实测恒星数量。
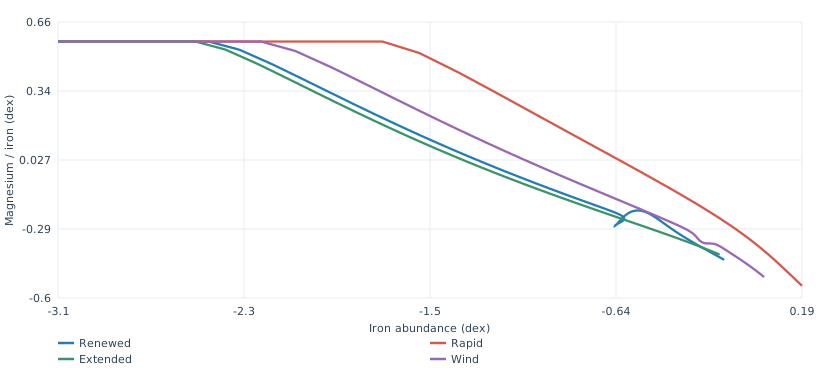
四份实际计算气体丰度轨迹,含再流入稀释形成的回转
从保存气体库存计算的四份自有指定历史。这些是气体轨迹,曲线长度不代表恒星出生质量;再流入使轨迹回转。图中没有实测恒星点。 查看完整图像

对应阅读:Weinberg, Andrews & Freudenburg, Equilibrium and Non-Equilibrium Aspects of Galactic Chemical Evolution, arXiv:1604.07435v1 · Independent one-zone chemical-evolution Python materials

先平均元素分数,再取对数

一个出生区间内,气体成分仍在变化。程序累计该区间锁入的镁、铁质量,再除以锁入总质量,得到这一代的出生平均分数。之后才把这些分数换成丰度方括号。

例题只比较铁,令两代的太阳单位铁分数分别为0.1和1,出生质量比例为1比9。线性质量分数平均是(1×0.1+9×1)/10=0.91(1\times0.1+9\times1)/10=0.91,取十进对数得到约−0.04096-0.04096。若先取各自对数,再按质量平均,结果是−0.1-0.1。它们回答的平均问题不同。

本模型采用固定氢比例,与太阳参考相同。相应换算为[Fe/H]=log⁡10(ZFe/ZFe,⊙)[\mathrm{Fe}/\mathrm H]=\log_{10}(Z_{\rm Fe}/Z_{{\rm Fe},\odot})。镁铁方括号则比较两个元素分数之比。实际氢比例若变化,需要重新写这一换算。

Z‾i,j=ΔMi,locked,jΔMlocked,j\overline Z_{i,j}=\frac{\Delta M_{i,\rm locked,j}}{\Delta M_{\rm locked,j}}
两个增量必须覆盖同一个出生区间。区间平均描述一代的代表成分,没有给这一代添加随机内部散布。

对应阅读:Independent one-zone chemical-evolution Python materials · VICE v1.3.1 fixed effective yields and solar reference

同一个铁测量,会把两个方向连起来

设横轴为x=[Fe/H]x=[\mathrm{Fe}/\mathrm H],纵轴为y=[Mg/Fe]y=[\mathrm{Mg}/\mathrm{Fe}]。铁测得偏高,会把点向右推,同时把镁相对铁向下拉;同一个铁误差影响了两个坐标。

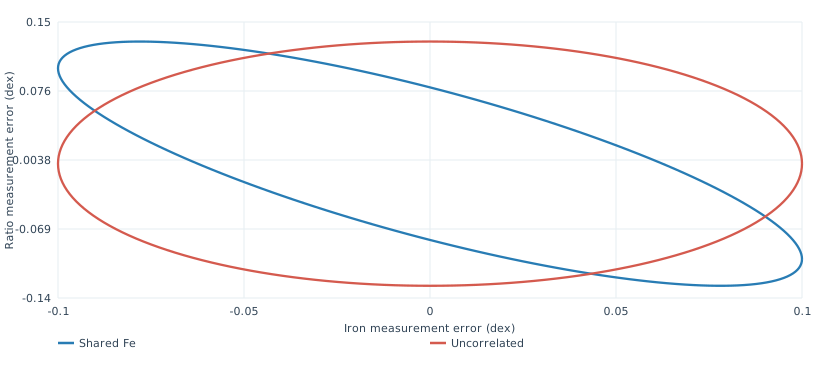
先看一个简化测量例子。假设绝对铁和绝对镁的对数测量误差互相独立,标准差分别为0.10和0.08dex。镁铁比是两者相减,它的标准差约0.12806dex;横纵坐标的相关系数约为负0.78087。误差椭圆因此向右下倾斜。

协方差记录两个误差是否一起偏。对这里的δx=δf\delta x=\delta f、δy=δm−δf\delta y=\delta m-\delta f,共享铁项给出Cov⁡(x,y)=−σf2\operatorname{Cov}(x,y)=-\sigma_f^2。这推导只属于刚才的独立绝对元素误差假设。

Hill表中的误差还含有大气温度、重力和谱线等共同来源。论文没有给出完整的逐星二维协方差。后面采用负0.7、零、正0.7三个相关系数作敏感性比较,都要标作假设,不能把这幅示意椭圆直接套到每颗真实恒星。

Σ=(σf2−σf2−σf2σm2+σf2)\Sigma=\begin{pmatrix}\sigma_f^2&-\sigma_f^2\\-\sigma_f^2&\sigma_m^2+\sigma_f^2\end{pmatrix}
矩阵左上、右下是两个坐标的方差,非对角项是协方差。例题中σf=0.10\sigma_f=0.10、σm=0.08\sigma_m=0.08,单位均为dex。
共享铁误差的负相关椭圆,与相同边际误差的零相关椭圆
自有线性误差算例,不是Hill协方差。蓝线由0.10和0.08 dex的独立绝对铁、镁误差变换得到;橙线保留相同边际误差而令相关为零。两线是高斯二次型等于一的轮廓,没有赋予校准置信区间。 查看完整图像

对应阅读:Hill et al., VLT/FLAMES high-resolution chemical abundances in Sculptor, arXiv:1812.01486v2 · Independent one-zone chemical-evolution Python materials

测量误差把出生分布摊成一片

现在从已经保存的出生区间出发。第jj个区间的代表丰度是μj\boldsymbol\mu_j,正权重是wjw_j,所有权重相加为1。第ii颗星的测量坐标记为di\boldsymbol d_i,误差矩阵为Σi\Sigma_i。

高斯分布是一团围绕模型真实值的钟形误差云。协方差“正定”,意思是沿任何方向看,误差方差都大于零。横纵标准差记为σx\sigma_x、σy\sigma_y,相关系数为ρ\rho,这里要求σx>0\sigma_x>0、σy>0\sigma_y>0且∣ρ∣<1|\rho|<1。

下面的行列式决定误差云面积尺度的平方;它的平方根以平方dex为单位,进入归一化因子。矩阵逆则把不同方向的偏离,按相应的误差尺度加权。

若用二维高斯分布描述测量误差,每个出生区间会在其代表丰度周围摊开。把这些小分布按出生权重相加,就得到这颗星在模型下的测量概率密度。高斯分布的前因子也要保留,特别是改变相关系数时。

概率密度的单位是每平方dex。它在某一点可以大于1;对一个有限区域积分,才得到落入那个区域的概率。比较整批测量时,把各星密度的自然对数相加,是这里采用的工作对数密度。它与丰度方括号使用的十进对数不同。

出生分箱仍有数值近似。教程保留0.02至0.01十亿年分箱未过门的结果,另用0.005至0.0025十亿年分箱,并对照正权时间积分。细化检验的是同一个观测积分,不会消除未知的天体物理假设。

det⁡Σ=σx2σy2(1−ρ2)\det\Sigma=\sigma_x^2\sigma_y^2(1-\rho^2)
边际误差相同,相关系数变化仍会改变误差云的面积,归一化后的高度也要跟着变。
pi=∑jwj N2(di−μj;Σi)N2(r;Σ)=exp⁡[−rTΣ−1r/2]2πdet⁡Σ\begin{aligned}p_i&=\sum_jw_j\,\mathcal N_2(\boldsymbol d_i-\boldsymbol\mu_j;\Sigma_i)\\\mathcal N_2(\boldsymbol r;\Sigma)&=\frac{\exp[-\boldsymbol r^{\mathsf T}\Sigma^{-1}\boldsymbol r/2]}{2\pi\sqrt{\det\Sigma}}\end{aligned}
二维高斯按整个平面积分为1,正权重之和为1,混合后的密度也归一化。矩阵逆描述沿误差椭圆不同方向偏离多少。

对应阅读:Independent one-zone chemical-evolution Python materials

红巨星目录为什么不等于出生质量分布

真实目录有自己的选样。Hill等人的目标来自玉夫座中心一个FLAMES视场,偏向亮红巨星,还经过成员、信噪比和谱线可测性筛选。能进入这张目录的恒星,不只是按出生质量随手抽出的样本。

若已知某个出生时刻、成分和质量的恒星被选中的机会,可以把它写成选择函数SS,乘到出生权重里再重新归一化。红巨星寿命、存活质量范围与视场位置,都可能影响SS。这里只取单位选择作为条件教学比较,没有重建该目录的选择函数。

太阳零点也要分清。模型固定采用VICE中的Asplund2009参考。Hill丰度到这套参考的数值零点差尚未确定,因此保留原观测坐标,另平移模型坐标作明确情景比较。这样的密度可以比较规定历史与测量的相容程度,不能单凭它宣布找到了玉夫座唯一的星形成史。

对应阅读:Hill et al., VLT/FLAMES high-resolution chemical abundances in Sculptor, arXiv:1812.01486v2 · VICE v1.3.1 fixed effective yields and solar reference · Independent one-zone chemical-evolution Python materials

练习与解释性答案

  1. 两段轨迹长度相同,其中一段形成的恒星质量是另一段的四倍,出生质量分布应给它们相同权重吗?

    展开解释

    不应。权重来自相应出生区间的形成量或锁入量。在这里归还比例固定,较大的一段占五分之四,另一段占五分之一;曲线长度没有进入这个归一化。

  2. 若独立绝对铁、镁的误差标准差都为0.10dex,共享铁导致的相关系数是多少?

    展开解释

    镁铁比的方差为0.102+0.102=0.020.10^2+0.10^2=0.02,与铁的协方差为−0.01-0.01,所以相关系数是−0.01/(0.100.02)=−1/2≈−0.7071-0.01/(0.10\sqrt{0.02})=-1/\sqrt2\approx-0.7071。这个负相关来自减去同一份铁误差。

  3. 一条规定历史比另一条得到更高的工作对数密度,为什么还不能说它正确重建了整个星系?

    展开解释

    排序以固定产额、选样权重、太阳参考和误差情景为条件。若这些条件不适合真实目录,较高分也可能只是几个不充分候选里相对更近的一组。还要研究整体拟合是否合适、独立样本及模型误差。

动手检验预测

比较同一气体库的不同历史

  1. 暂停后看已经出生的世代,解释它们的颜色为什么保留,而气体颜色还能改变。
  2. 对照外侧丰度图与源史,指出哪一段形成量较多,不能只凭曲线长度判断。
  3. 导出同一个实验,找出每代的锁入质量与镁铁出生分数,再说明还缺哪些信息才能模拟红巨星选样。

来源与计算范围

  1. Weinberg, Andrews & Freudenburg, Equilibrium and Non-Equilibrium Aspects of Galactic Chemical Evolution, arXiv:1604.07435v1

    重新完整核读固定30页正文与两附录。第2至3节用于产额、回收和解析极限,第5节用于延迟近似及出生权重。原文的氧与指数延迟例子没有换名充作本课程固定镁产额和有限幂律核;原文与气体相连的形成律也不同于这里的指定历史。

  2. Hill et al., VLT/FLAMES high-resolution chemical abundances in Sculptor, arXiv:1812.01486v2

    重新核读第1至7节、附录A/B,并以两种文本模式实际提取表C5,99行及96个有效镁铁测量完全一致。方法段定义25角分直径视场和上红巨星支选择;结论段半径措辞不一致。未建立完整逐星协方差或到模型太阳参考的数值转换。原观测、PDF和实测派生图只留读者本地。

  3. VICE v1.3.1 fixed effective yields and solar reference

    使用此前冻结的原生默认约定:Kroupa、核坍缩与Ia型的有效净镁铁产额、Asplund 2009太阳参考及声明的氢转换。公开资料仅有标量和身份,没有新产额网格或VICE可执行程序;独立Python不运行VICE。

  4. Independent one-zone chemical-evolution Python materials

    自有连续卷积与DOP853实际producer,保存十四字段库存和出生群体,检查有限细化、归一化条件混合密度与数学极限。公开输入和图均为自有合成。默认离线,可选固定Hill源在读者电脑获取分析。没有Lab引擎、原论文、观测行或实测派生图。

反馈这个页面有错误、看不明白,或者缺了什么?告诉我们
反馈类型

提交时会附带本页地址、Lab ID、网站语言和设备类型。请不要填写个人信息。反馈最多保存 12 个月。隐私政策